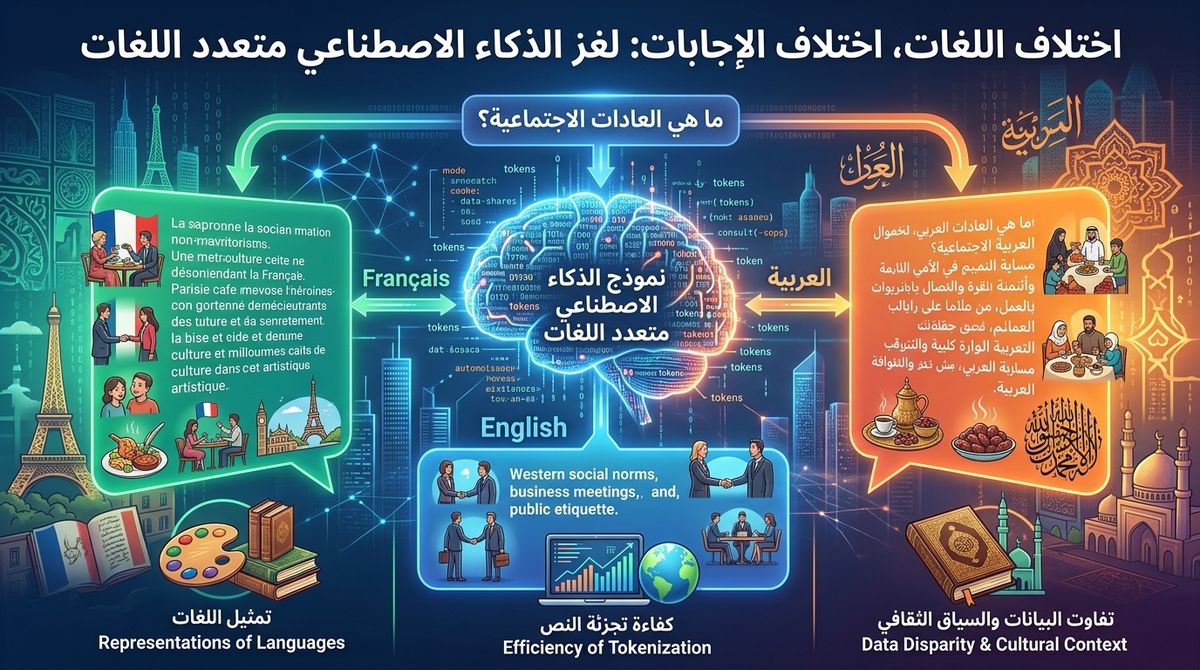
قد يتبادر إلى الذهن أن طرح السؤال ذاته على نماذج الذكاء الاصطناعي باللغة العربية أو الإنجليزية أو الفرنسية سيفضي حتماً إلى النتيجة والإجابة عينها. بيد أن الواقع التقني ينطوي على تعقيدات مختلفة؛ إذ لا تتعامل النماذج اللغوية متعددة اللغات مع كل لغة بالأسلوب ذاته. ويتجلى هذا التباين في دقة المعلومات المعروضة، أو اختيار الألفاظ والمصطلحات، أو التفاصيل والقرائن التي يسترجعها النموذج، بل وحتى في طريقة استيعابه للسياقات الثقافية المحيطة بالسؤال. ولا يعني هذا السلوك التقني بأي حال من الأحوال أن النموذج "يفكر" بلغة أفضل من غيرها، وإنما يرجع الأمر برمته إلى طبيعة آلية تدريبه، وكيفية تمثيل اللغات المختلفة داخل بنيته الخوارزمية.
بيانات التدريب: نقطة الانطلاق والأساس المفصلي
تعتمد النماذج اللغوية الكبيرة في تكوين معرفتها على ضخ كميات مهولة من النصوص خلال المراحل الأولى لتدريبها. غير أن هذه البيانات والمعارف النصية ليست موزعة بالتساوي بين لغات العالم؛ فاللغة الإنجليزية واللغات ذات الزخم الرقمي المرتفع تحظى بوفرة استثنائية من الموارد النصية، في حين تواجه لغات عديدة شحاً ونقصاً ملحوظاً في البيانات عالية الجودة.
وفي هذا الصدد، كشفت دراسة بحثية نُشرت في دورية "ساينتفيك ريبورتس" (Scientific Reports)، والتي أخضعت ثلاثة نماذج ذكاء اصطناعي للاختبار عبر 12 لغة مختلفة، أن أداء هذه النماذج يتفاوت تفاوتًا ملموسًا بناءً على اللغة المستخدمة. وأوضحت الدراسة أن حجم بيانات التدريب ومصدرها، إلى جانب "المسافة اللغوية" وطريقة تجزئة النصوص، تشكل جميعها عوامل حاسمة تؤثر في جودة الأداء. ومن اللافت في نتائج هذه الاختبارات أن اللغة الإنجليزية لم تكن دائماً هي الأكثر تفوقاً وسيطرة، بل استطاعت لغات أخرى التفوق عليها في مهام محددة.
وتتكامل هذه النتائج مع أبحاث علمية أخرى تناولت بالدراسة أكثر من 250 لغة، حيث وجدت أن إثراء النماذج ببيانات متعددة اللغات يمكن أن يُحسن بشكل ملحوظ من أداء اللغات منخفضة الموارد. إلا أن حجم الفائدة المكتسبة يظل مرهوناً بحجم البيانات المضافة ومستوى التشابه اللغوي بين تلك اللغات، مع التنبيه إلى أن التوسع المفرط وغير المدروس في عدد اللغات قد يفرز قيوداً وعوائق تحد من القدرات العامة للنموذج.
طريقة تجزئة النص (التوكنات): العائق الحسابي الخفي
قبل أن يبدأ النموذج في معالجة الاستفسار الموجه إليه، تخضع النصوص المكتوبة لعملية تحويل رقمية تُقسم فيها الكلمات إلى وحدات أصغر تُعرف بـ "الرموز" أو "التوكنات" (Tokens). ولا تتم هذه العملية الهندسية بطريقة متطابقة بين اللغات المختلفة.
وقد أظهرت الأبحاث الحديثة أن اختيار الخوارزمية الخاصة بتقسيم النص إلى رموز ينعكس بشكل مباشر على كفاءة أداء النموذج وتكلفة تدريبه. فعند استخدام أدوات تجزئة مصممة بالأساس لخدمة البنية اللغوية الإنجليزية، يطرأ تراجع حاد في الأداء عند التعامل مع لغات أخرى، وذلك نتيجة لعدم كفاءة التمثيل الرقمي للنصوص غير الإنجليزية.
كما أكدت دراسة قُدمت في مؤتمر "جمعية اللغويات الحاسوبية لعام 2025" أن أساليب تقطيع النصوص تتأثر عميقاً بالتنوع اللغوي، وأن هذا الاختلاف يترك أثراً واضحاً على مخرجات النماذج اللغوية في مختلف المهام. ونتيجة لذلك، فإن أي سؤالين متطابقين تماماً في المعنى بين لغتين قد يصلان إلى المحرك الحسابي للنموذج في هيئة شفرات ورموز مختلفة تماماً من الناحية الحسابية.
الارتباط الوثيق بين اللغة والثقافة
إن القضية لا تقف عند حدود البيانات والتراكيب البرمجية فحسب؛ إذ تتعداها إلى السياق الثقافي الذي تحمله الأسئلة حتى وإن كانت بسيطة في ظاهرها. وقد قدمت دراسة سلطت الضوء على هذا البعد في مؤتمر "إيه سي إل 2025" (ACL 2025)، حيث طرح الباحثون مفهوم "التآزر اللغوي الثقافي"، مبيّنين أن النماذج تحقق أدوات وإجابات أفضل عندما ينسجم السؤال ثقافياً مع اللغة المستعملة، مما يستوجب عدم فصل اللغة عن خلفيتها الثقافية عند تقييم الذكاء الاصطناعي.
وأشارت أبحاث أخرى إلى أن النماذج قد تختزن معرفة وثقافية محلية بالفعل، ولكنها لا تستحضر هذه المعرفة تلقائياً بمجرد الصياغة بلغة معينة. وفي كثير من الأحيان، يتطلب الأمر إدراج السياق الثقافي بشكل صريح ومباشر ضمن السؤال لتحفيز النموذج على تقديم إجابة ذات طابع محلي دقيق. ويتضح هذا التباين جلياً عند الاستفسار عن التقاليد الاجتماعية، أو الأمثال الشعبية، أو الأنظمة القانونية؛ حيث قد تختلف الإجابة باختلاف اللغة، نظراً لأن اللغة ذاتها تمنح النموذج إشارات إيحائية ودلالات تشير إلى البيئة أو البلد المقصود.
واقع اللغة العربية واللغات الأقل تمثيلاً
تزداد هذه الفجوة وضوحاً عند التعامل مع اللغات واللهجات ذات الموارد الرقمية المحدودة. وفيما يخص اللغة العربية، لا يقتصر التحدي على النص الفصيح فحسب، بل يتعداه إلى التنوع الهائل في اللهجات والسياقات المحلية والإقليمية.
وفقاً للورقة البحثية الخاصة بمؤشر نضج تقنيات الذكاء الاصطناعي للغة العربية "بلسم" (BALSAM)، المنشورة ضمن أعمال مؤتمر معالجة اللغة العربية 2025، فإن أداء النماذج باللغة العربية يتأثر بعدة عوامل معقدة، أبرزها: ندرة البيانات عالية الجودة، والتنوع اللغوي والتعدد اللهجي، والتعقيد الصرفي والتركيب البنيوي للغة العربية، إضافة إلى النقص الحاد في أدوات القياس والاختبارات المعيارية المتخصصة.
ولمعالجة هذه الفجوة القائمة بين العربية الفصحى واللهجات الثقافية المختلفة، طوّر الباحثون معيار "أراديس" (AraDiCE)، وهو أداة مخصصة لاختبار قدرات النماذج الذكية في استيعاب اللهجات العربية والوعي الثقافي السائد في مناطق الخليج العربي ومصر وبلاد الشام.
من جانبها، نبهت منظمة "اليونسكو" إلى أن تقنيات الذكاء الاصطناعي التي جرى تدريبها بالأساس على اللغات المهيمنة عالمياً قد تكون أقل كفاءة وفعالية عند تطبيقها على بعض اللغات الأفريقية. وأكدت المنظمة أن شح البيانات المحلية لا يضعف جودة المخرجات اللغوية فحسب، بل يحد أيضاً من قدرة هذه الأنظمة الذكية على استيعاب المفاهيم والرموز الثقافية المحلية وتناولها بالدقة المطلوبة.
هل التباين في الإجابات دليل على التحيز؟
من زاوية أخرى، يرى الخبراء أن تفاوت الإجابة بين لغة وأخرى لا ينبغي تفسيره دوماً كدليل مباشر على وجود تحيز متعمد. فقد يكون هذا الاختلاف نتاجاً طبيعياً لتفاوت حجم البيانات، أو أسلوب تجزئة النصوص، أو الاختلافات في السياق الثقافي، أو حتى التباين اللفظي في طريقة صياغة السؤال.
ومع ذلك، قد تتسبب هذه الفوارق المنهجية في إنتاج "تحيز لغوي" فعلي في المخرجات والنتائج، لا سيما عندما تكون إحدى اللغات ممثلة ببيانات ضئيلة، أو عندما تعتمد اختبارات تقييم النماذج على مقاييس صُممت خصيصاً للغات الأكثر انتشاراً عالمياً.
وبناءً على ذلك، تتجه الأبحاث المعاصرة نحو تقييم واختبار نماذج الذكاء الاصطناعي عبر لغات وثقافات متعددة ومتباينة، بدلاً من الاقتصار على قياس قدراتها باللغة الإنجليزية فقط. فالهدف لم يعد محصوراً في التساؤل المباشر: "هل يفهم النموذج هذه اللغة؟"، بل اتسع ليشمل التساؤل الجوهري: "هل يستوعب النموذج السؤال ضمن سياقه الثقافي واللغوي الأصيل الذي نشأ فيه؟".
وفي الختام، يؤكد الباحثون والخبراء أن اختلاف المخرجات والإجابات بين اللغات يكشف عن حقيقة تقنية مفادها أن الذكاء الاصطناعي لا يستخرج معلومات ثابتة ومجردة من قاعدة بيانات واحدة، بل يبني مخرجاته بالكامل بناءً على التمثيلات اللغوية والثقافية التي تبلورت في بنيته خلال مرحلة التدريب. وكلما تغيرت اللغة والسياق والبيانات المتاحة، تبدلت المسارات التقنية التي يسلكها النموذج للوصول إلى إجابته النهائية.
إليك المقال بعد إعادة صياغته بشكل كامل وتفصيلي دون أي اختصار، مع الحفاظ على جميع الدراسات والمصطلحات والمراجع المذكورة:
خفايا الذكاء الاصطناعي متعدد اللغات: لماذا تختلف الإجابات باختلاف اللغة والتقنيات الكامنة؟
قد يتبادر إلى الذهن أن طرح السؤال ذاته على نماذج الذكاء الاصطناعي باللغة العربية أو الإنجليزية أو الفرنسية سيفضي حتماً إلى النتيجة والإجابة عينها. بيد أن الواقع التقني ينطوي على تعقيدات مختلفة؛ إذ لا تتعامل النماذج اللغوية متعددة اللغات مع كل لغة بالأسلوب ذاته. ويتجلى هذا التباين في دقة المعلومات المعروضة، أو اختيار الألفاظ والمصطلحات، أو التفاصيل والقرائن التي يسترجعها النموذج، بل وحتى في طريقة استيعابه للسياقات الثقافية المحيطة بالسؤال. ولا يعني هذا السلوك التقني بأي حال من الأحوال أن النموذج "يفكر" بلغة أفضل من غيرها، وإنما يرجع الأمر برمته إلى طبيعة آلية تدريبه، وكيفية تمثيل اللغات المختلفة داخل بنيته الخوارزمية.
بيانات التدريب: نقطة الانطلاق والأساس المفصلي
تعتمد النماذج اللغوية الكبيرة في تكوين معرفتها على ضخ كميات مهولة من النصوص خلال المراحل الأولى لتدريبها. غير أن هذه البيانات والمعارف النصية ليست موزعة بالتساوي بين لغات العالم؛ فاللغة الإنجليزية واللغات ذات الزخم الرقمي المرتفع تحظى بوفرة استثنائية من الموارد النصية، في حين تواجه لغات عديدة شحاً ونقصاً ملحوظاً في البيانات عالية الجودة.
وفي هذا الصدد، كشفت دراسة بحثية نُشرت في دورية "ساينتفيك ريبورتس" (Scientific Reports)، والتي أخضعت ثلاثة نماذج ذكاء اصطناعي للاختبار عبر 12 لغة مختلفة، أن أداء هذه النماذج يتفاوت تفاوتًا ملموسًا بناءً على اللغة المستخدمة. وأوضحت الدراسة أن حجم بيانات التدريب ومصدرها، إلى جانب "المسافة اللغوية" وطريقة تجزئة النصوص، تشكل جميعها عوامل حاسمة تؤثر في جودة الأداء. ومن اللافت في نتائج هذه الاختبارات أن اللغة الإنجليزية لم تكن دائماً هي الأكثر تفوقاً وسيطرة، بل استطاعت لغات أخرى التفوق عليها في مهام محددة.
وتتكامل هذه النتائج مع أبحاث علمية أخرى تناولت بالدراسة أكثر من 250 لغة، حيث وجدت أن إثراء النماذج ببيانات متعددة اللغات يمكن أن يُحسن بشكل ملحوظ من أداء اللغات منخفضة الموارد. إلا أن حجم الفائدة المكتسبة يظل مرهوناً بحجم البيانات المضافة ومستوى التشابه اللغوي بين تلك اللغات، مع التنبيه إلى أن التوسع المفرط وغير المدروس في عدد اللغات قد يفرز قيوداً وعوائق تحد من القدرات العامة للنموذج.
طريقة تجزئة النص (التوكنات): العائق الحسابي الخفي
قبل أن يبدأ النموذج في معالجة الاستفسار الموجه إليه، تخضع النصوص المكتوبة لعملية تحويل رقمية تُقسم فيها الكلمات إلى وحدات أصغر تُعرف بـ "الرموز" أو "التوكنات" (Tokens). ولا تتم هذه العملية الهندسية بطريقة متطابقة بين اللغات المختلفة.
وقد أظهرت الأبحاث الحديثة أن اختيار الخوارزمية الخاصة بتقسيم النص إلى رموز ينعكس بشكل مباشر على كفاءة أداء النموذج وتكلفة تدريبه. فعند استخدام أدوات تجزئة مصممة بالأساس لخدمة البنية اللغوية الإنجليزية، يطرأ تراجع حاد في الأداء عند التعامل مع لغات أخرى، وذلك نتيجة لعدم كفاءة التمثيل الرقمي للنصوص غير الإنجليزية.
كما أكدت دراسة قُدمت في مؤتمر "جمعية اللغويات الحاسوبية لعام 2025" أن أساليب تقطيع النصوص تتأثر عميقاً بالتنوع اللغوي، وأن هذا الاختلاف يترك أثراً واضحاً على مخرجات النماذج اللغوية في مختلف المهام. ونتيجة لذلك، فإن أي سؤالين متطابقين تماماً في المعنى بين لغتين قد يصلان إلى المحرك الحسابي للنموذج في هيئة شفرات ورموز مختلفة تماماً من الناحية الحسابية.
الارتباط الوثيق بين اللغة والثقافة
إن القضية لا تقف عند حدود البيانات والتراكيب البرمجية فحسب؛ إذ تتعداها إلى السياق الثقافي الذي تحمله الأسئلة حتى وإن كانت بسيطة في ظاهرها. وقد قدمت دراسة سلطت الضوء على هذا البعد في مؤتمر "إيه سي إل 2025" (ACL 2025)، حيث طرح الباحثون مفهوم "التآزر اللغوي الثقافي"، مبيّنين أن النماذج تحقق أدوات وإجابات أفضل عندما ينسجم السؤال ثقافياً مع اللغة المستعملة، مما يستوجب عدم فصل اللغة عن خلفيتها الثقافية عند تقييم الذكاء الاصطناعي.
وأشارت أبحاث أخرى إلى أن النماذج قد تختزن معرفة وثقافية محلية بالفعل، ولكنها لا تستحضر هذه المعرفة تلقائياً بمجرد الصياغة بلغة معينة. وفي كثير من الأحيان، يتطلب الأمر إدراج السياق الثقافي بشكل صريح ومباشر ضمن السؤال لتحفيز النموذج على تقديم إجابة ذات طابع محلي دقيق. ويتضح هذا التباين جلياً عند الاستفسار عن التقاليد الاجتماعية، أو الأمثال الشعبية، أو الأنظمة القانونية؛ حيث قد تختلف الإجابة باختلاف اللغة، نظراً لأن اللغة ذاتها تمنح النموذج إشارات إيحائية ودلالات تشير إلى البيئة أو البلد المقصود.
واقع اللغة العربية واللغات الأقل تمثيلاً
تزداد هذه الفجوة وضوحاً عند التعامل مع اللغات واللهجات ذات الموارد الرقمية المحدودة. وفيما يخص اللغة العربية، لا يقتصر التحدي على النص الفصيح فحسب، بل يتعداه إلى التنوع الهائل في اللهجات والسياقات المحلية والإقليمية.
وفقاً للورقة البحثية الخاصة بمؤشر نضج تقنيات الذكاء الاصطناعي للغة العربية "بلسم" (BALSAM)، المنشورة ضمن أعمال مؤتمر معالجة اللغة العربية 2025، فإن أداء النماذج باللغة العربية يتأثر بعدة عوامل معقدة، أبرزها: ندرة البيانات عالية الجودة، والتنوع اللغوي والتعدد اللهجي، والتعقيد الصرفي والتركيب البنيوي للغة العربية، إضافة إلى النقص الحاد في أدوات القياس والاختبارات المعيارية المتخصصة.
ولمعالجة هذه الفجوة القائمة بين العربية الفصحى واللهجات الثقافية المختلفة، طوّر الباحثون معيار "أراديس" (AraDiCE)، وهو أداة مخصصة لاختبار قدرات النماذج الذكية في استيعاب اللهجات العربية والوعي الثقافي السائد في مناطق الخليج العربي ومصر وبلاد الشام.
من جانبها، نبهت منظمة "اليونسكو" إلى أن تقنيات الذكاء الاصطناعي التي جرى تدريبها بالأساس على اللغات المهيمنة عالمياً قد تكون أقل كفاءة وفعالية عند تطبيقها على بعض اللغات الأفريقية. وأكدت المنظمة أن شح البيانات المحلية لا يضعف جودة المخرجات اللغوية فحسب، بل يحد أيضاً من قدرة هذه الأنظمة الذكية على استيعاب المفاهيم والرموز الثقافية المحلية وتناولها بالدقة المطلوبة.
هل التباين في الإجابات دليل على التحيز؟
من زاوية أخرى، يرى الخبراء أن تفاوت الإجابة بين لغة وأخرى لا ينبغي تفسيره دوماً كدليل مباشر على وجود تحيز متعمد. فقد يكون هذا الاختلاف نتاجاً طبيعياً لتفاوت حجم البيانات، أو أسلوب تجزئة النصوص، أو الاختلافات في السياق الثقافي، أو حتى التباين اللفظي في طريقة صياغة السؤال.
ومع ذلك، قد تتسبب هذه الفوارق المنهجية في إنتاج "تحيز لغوي" فعلي في المخرجات والنتائج، لا سيما عندما تكون إحدى اللغات ممثلة ببيانات ضئيلة، أو عندما تعتمد اختبارات تقييم النماذج على مقاييس صُممت خصيصاً للغات الأكثر انتشاراً عالمياً.
وبناءً على ذلك، تتجه الأبحاث المعاصرة نحو تقييم واختبار نماذج الذكاء الاصطناعي عبر لغات وثقافات متعددة ومتباينة، بدلاً من الاقتصار على قياس قدراتها باللغة الإنجليزية فقط. فالهدف لم يعد محصوراً في التساؤل المباشر: "هل يفهم النموذج هذه اللغة؟"، بل اتسع ليشمل التساؤل الجوهري: "هل يستوعب النموذج السؤال ضمن سياقه الثقافي واللغوي الأصيل الذي نشأ فيه؟".
وفي الختام، يؤكد الباحثون والخبراء أن اختلاف المخرجات والإجابات بين اللغات يكشف عن حقيقة تقنية مفادها أن الذكاء الاصطناعي لا يستخرج معلومات ثابتة ومجردة من قاعدة بيانات واحدة، بل يبني مخرجاته بالكامل بناءً على التمثيلات اللغوية والثقافية التي تبلورت في بنيته خلال مرحلة التدريب. وكلما تغيرت اللغة والسياق والبيانات المتاحة، تبدلت المسارات التقنية التي يسلكها النموذج للوصول إلى إجابته النهائية.