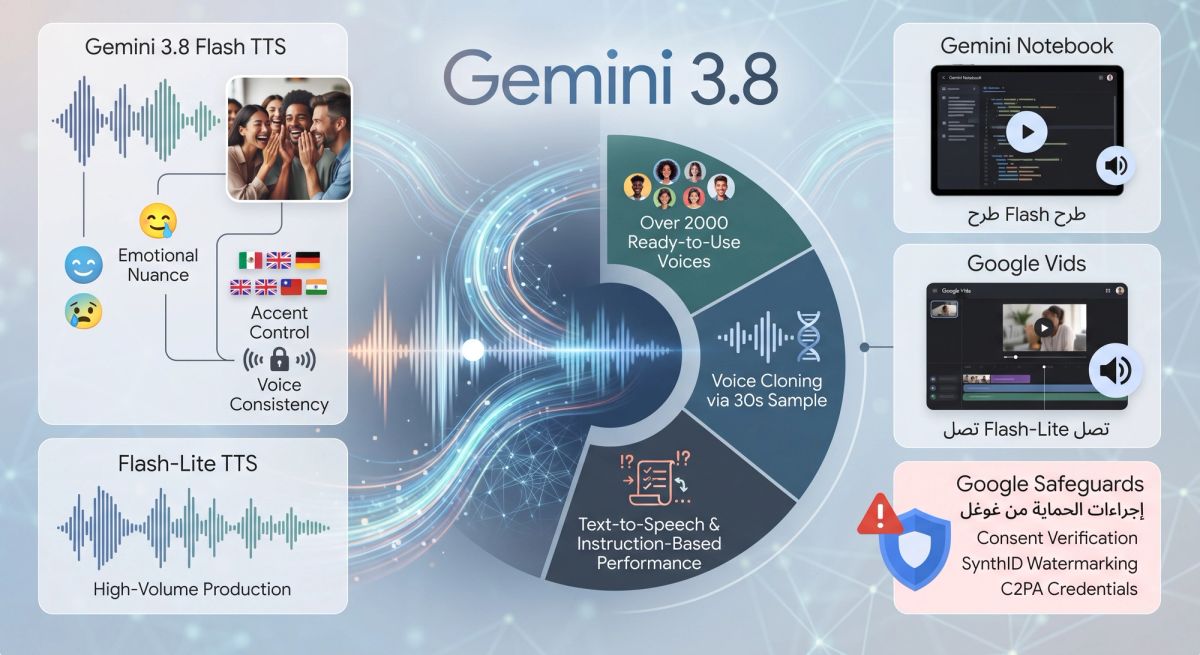
أعلنت شركة غوغل عن توسيع قدرات نماذج الذكاء الاصطناعي الخاصة بها، جيميناي، لتشمل أداءً صوتيًا أكثر واقعية وتعبيرية. وتأتي هذه الخطوة ضمن توسع "غوغل" في عائلة Gemini 3.8، والتي بدأت بنموذج Gemini 3.8 Flash، قبل أن تضيف الشركة نماذج Live وLive Extended Thinking، والآن نماذج تحويل النص إلى كلام (Text-to-Speech) المتقدمة: Gemini 3.8 Flash TTS وFlash-Lite TTS.
ووفقًا لما أعلنته غوغل في منشور على مدونتها، يتمثل أبرز ما يقدمه هذا التحديث للمستخدمين في مستوى التحكم غير المسبوق في الأداء الصوتي. حيث أصبح بإمكان النظام استنساخ الأصوات بدقة عالية، وتنفيذ النصوص بأسلوب أقرب إلى أداء الممثلين المحترفين، مع التحكم الدقيق في النبرة واللهجة والإيقاع والمشاعر، وحتى التوقفات الطبيعية والتنهدات.
وتشمل القدرات الجديدة للنماذج ما يلي:
إنشاء صوت أصلي: يستطيع Gemini 3.8 Flash TTS إنشاء صوت أصلي بالكامل انطلاقًا من وصف مكتوب باللغة الطبيعية، مع دعم واسع لأكثر من 100 لغة ولهجة.
مكتبة أصوات ضخمة واستنساخ سريع: توفر غوغل أكثر من 2000 صوت جاهز للاستخدام الفوري في الإنتاج، إلى جانب إمكانية استنساخ صوت متسق اعتمادًا على عينة صوتية قصيرة مدتها 30 ثانية فقط، وذلك بشرط امتلاك المستخدم الإذن اللازم لاستخدام الصوت.
تنفيذ تعليمات دقيقة: لا تقتصر التقنية على تحويل النص المكتوب إلى ملف صوتي، بل يستطيع النموذجان تنفيذ تعليمات دقيقة سطرًا بسطر لتحديد النبرة، وسرعة الحديث، واللهجة، وحتى إدراج الهمس والضحك والتنهدات وغيرها من الإشارات الحوارية لضمان محاكاة الأداء البشري.
الحفاظ على ثبات الأصوات: يمكن للنظام إنشاء محادثات معقدة بين شخصين انطلاقًا من نص واحد، مع الحفاظ على ثبات أصوات الشخصيات عبر تسجيلات صوتية تمتد لساعات، مما يقلل الطابع الآلي الذي كان يميز الأصوات المولدة بالذكاء الاصطناعي.
وتفتح هذه القدرات المتقدمة المجال أمام استخدامات متعددة وواسعة النطاق، من بينها إنتاج البودكاست، والكتب الصوتية، والدبلجة، والوكلاء الصوتيون، ومقاطع الفيديو المروية.
وقد أظهرت نتائج الاختبارات التي أجرتها "غوغل" أداءً قويًا للنماذج الجديدة. فقد تصدر Gemini 3.8 Flash TTS الترتيب العام في اختبار Voice Design Benchmark التابع لشركة Hume AI، مسجلاً 60.8 نقطة في فئة اللهجات. كما احتل نموذجا Flash وFlash-Lite المركزين الأول والثاني في مؤشر الجودة العام لدى Hume. وأظهرت اختبارات Voice Arena أيضًا نتائج وضعت النموذجين في الصدارة أو بالقرب منها عبر عدد من اللغات. ومع ذلك، أشارت الاختبارات إلى أن المنافسة لا تزال قائمة، حيث سجلت شركة ElevenLabs نتائج أعلى في اختبارات Hume المتعلقة بجودة الصوت الفردي ومدى التنوع الشبيه بالأصوات البشرية.
وبدأت "غوغل" بالفعل في طرح هذه التقنية للمستخدمين والمطورين على حد سواء. فقد تم طرح Flash TTS داخل تطبيق Gemini Notebook، بينما يصل Flash-Lite TTS إلى خدمة Google Vids، وذلك بالتزامن مع إتاحة أحدث مولد فيديو Omni في Google Vids لعدد أكبر من المستخدمين. أما المطورون، فيمكنهم الوصول إلى النموذجين من خلال Gemini API وAI Studio.
وفي ظل المخاوف المرتبطة بإمكانية إساءة استخدام تقنية استنساخ الأصوات، وضعت غوغل عددًا من إجراءات الحماية الصارمة. وتتطلب الشركة التحقق من الحصول على موافقة صاحب الصوت قبل استخدامه في عملية الاستنساخ، كما تضيف تقنية SynthID للعلامات المائية، إلى جانب بيانات اعتماد C2PA للمساعدة في تحديد المحتوى المولد بالذكاء الاصطناعي. كما تحظر "غوغل" ميزة استنساخ الأصوات داخل AI Studio في عدد من المناطق، من بينها المملكة المتحدة، والمنطقة الاقتصادية الأوروبية، والهند، وولاية تكساس، وولاية إلينوي.
وبذلك تتحول تقنيات تحويل النص إلى كلام في جيميناي من مجرد أدوات لقراءة النصوص إلى أنظمة قادرة على تقديم أداء صوتي أكثر تعقيدًا، مع منح المستخدم تحكمًا أكبر في الطريقة التي يتم بها إلقاء كل جملة وتقديم كل مشهد.